用 StreamCap 和本地 Whisper 总结财经直播:从自动录音到观点报告

起因:最近科技跌的厉害,所以我又重新开始看起了财经直播,准备寻找一个入场的机会,但是财经主播讲的大部分是废话,可能偶尔一两句话是重点,而且一下要看一个小时,于是乎就产生了让 ai 帮我总结的方法。
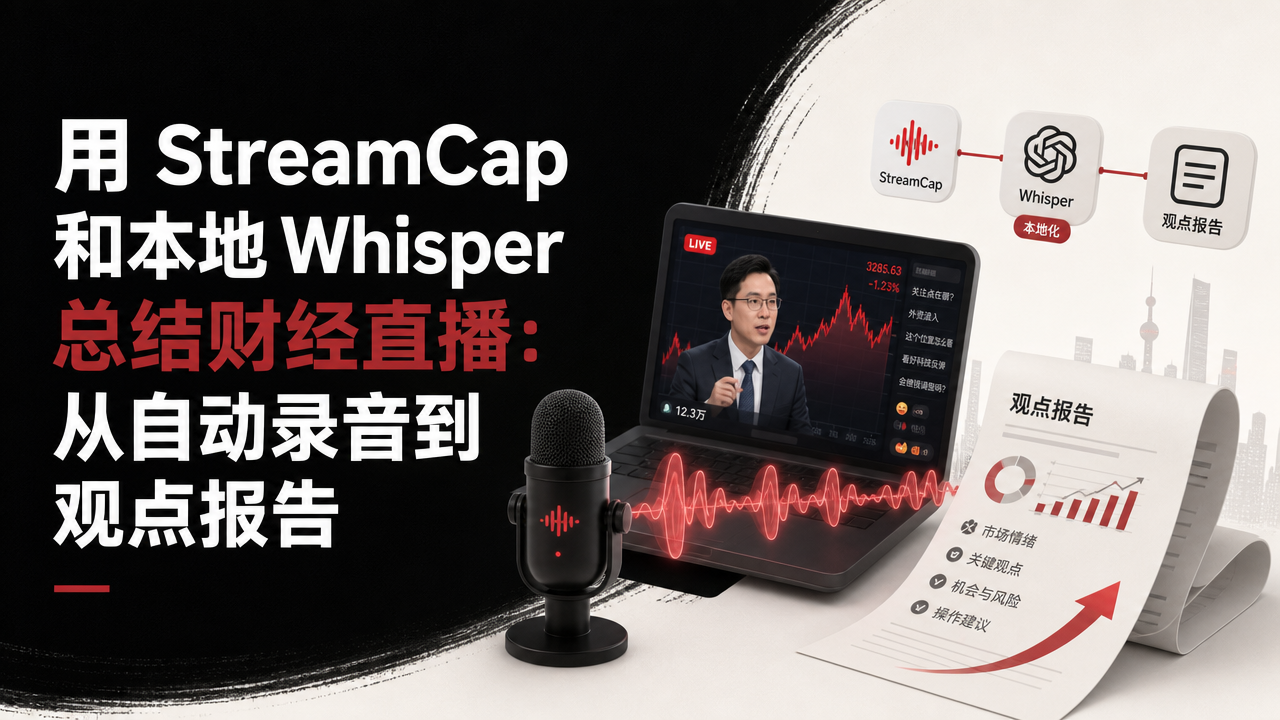
整体流程
主播开播
  ↓
StreamCap 自动监听并分段录音
  ↓
本地 Whisper 转成带时间戳的文字稿
  ↓
GPT 区分观点、论据、预测和事实
  ↓
生成 Markdown 复盘报告
第一步:用 StreamCap 监听并录音
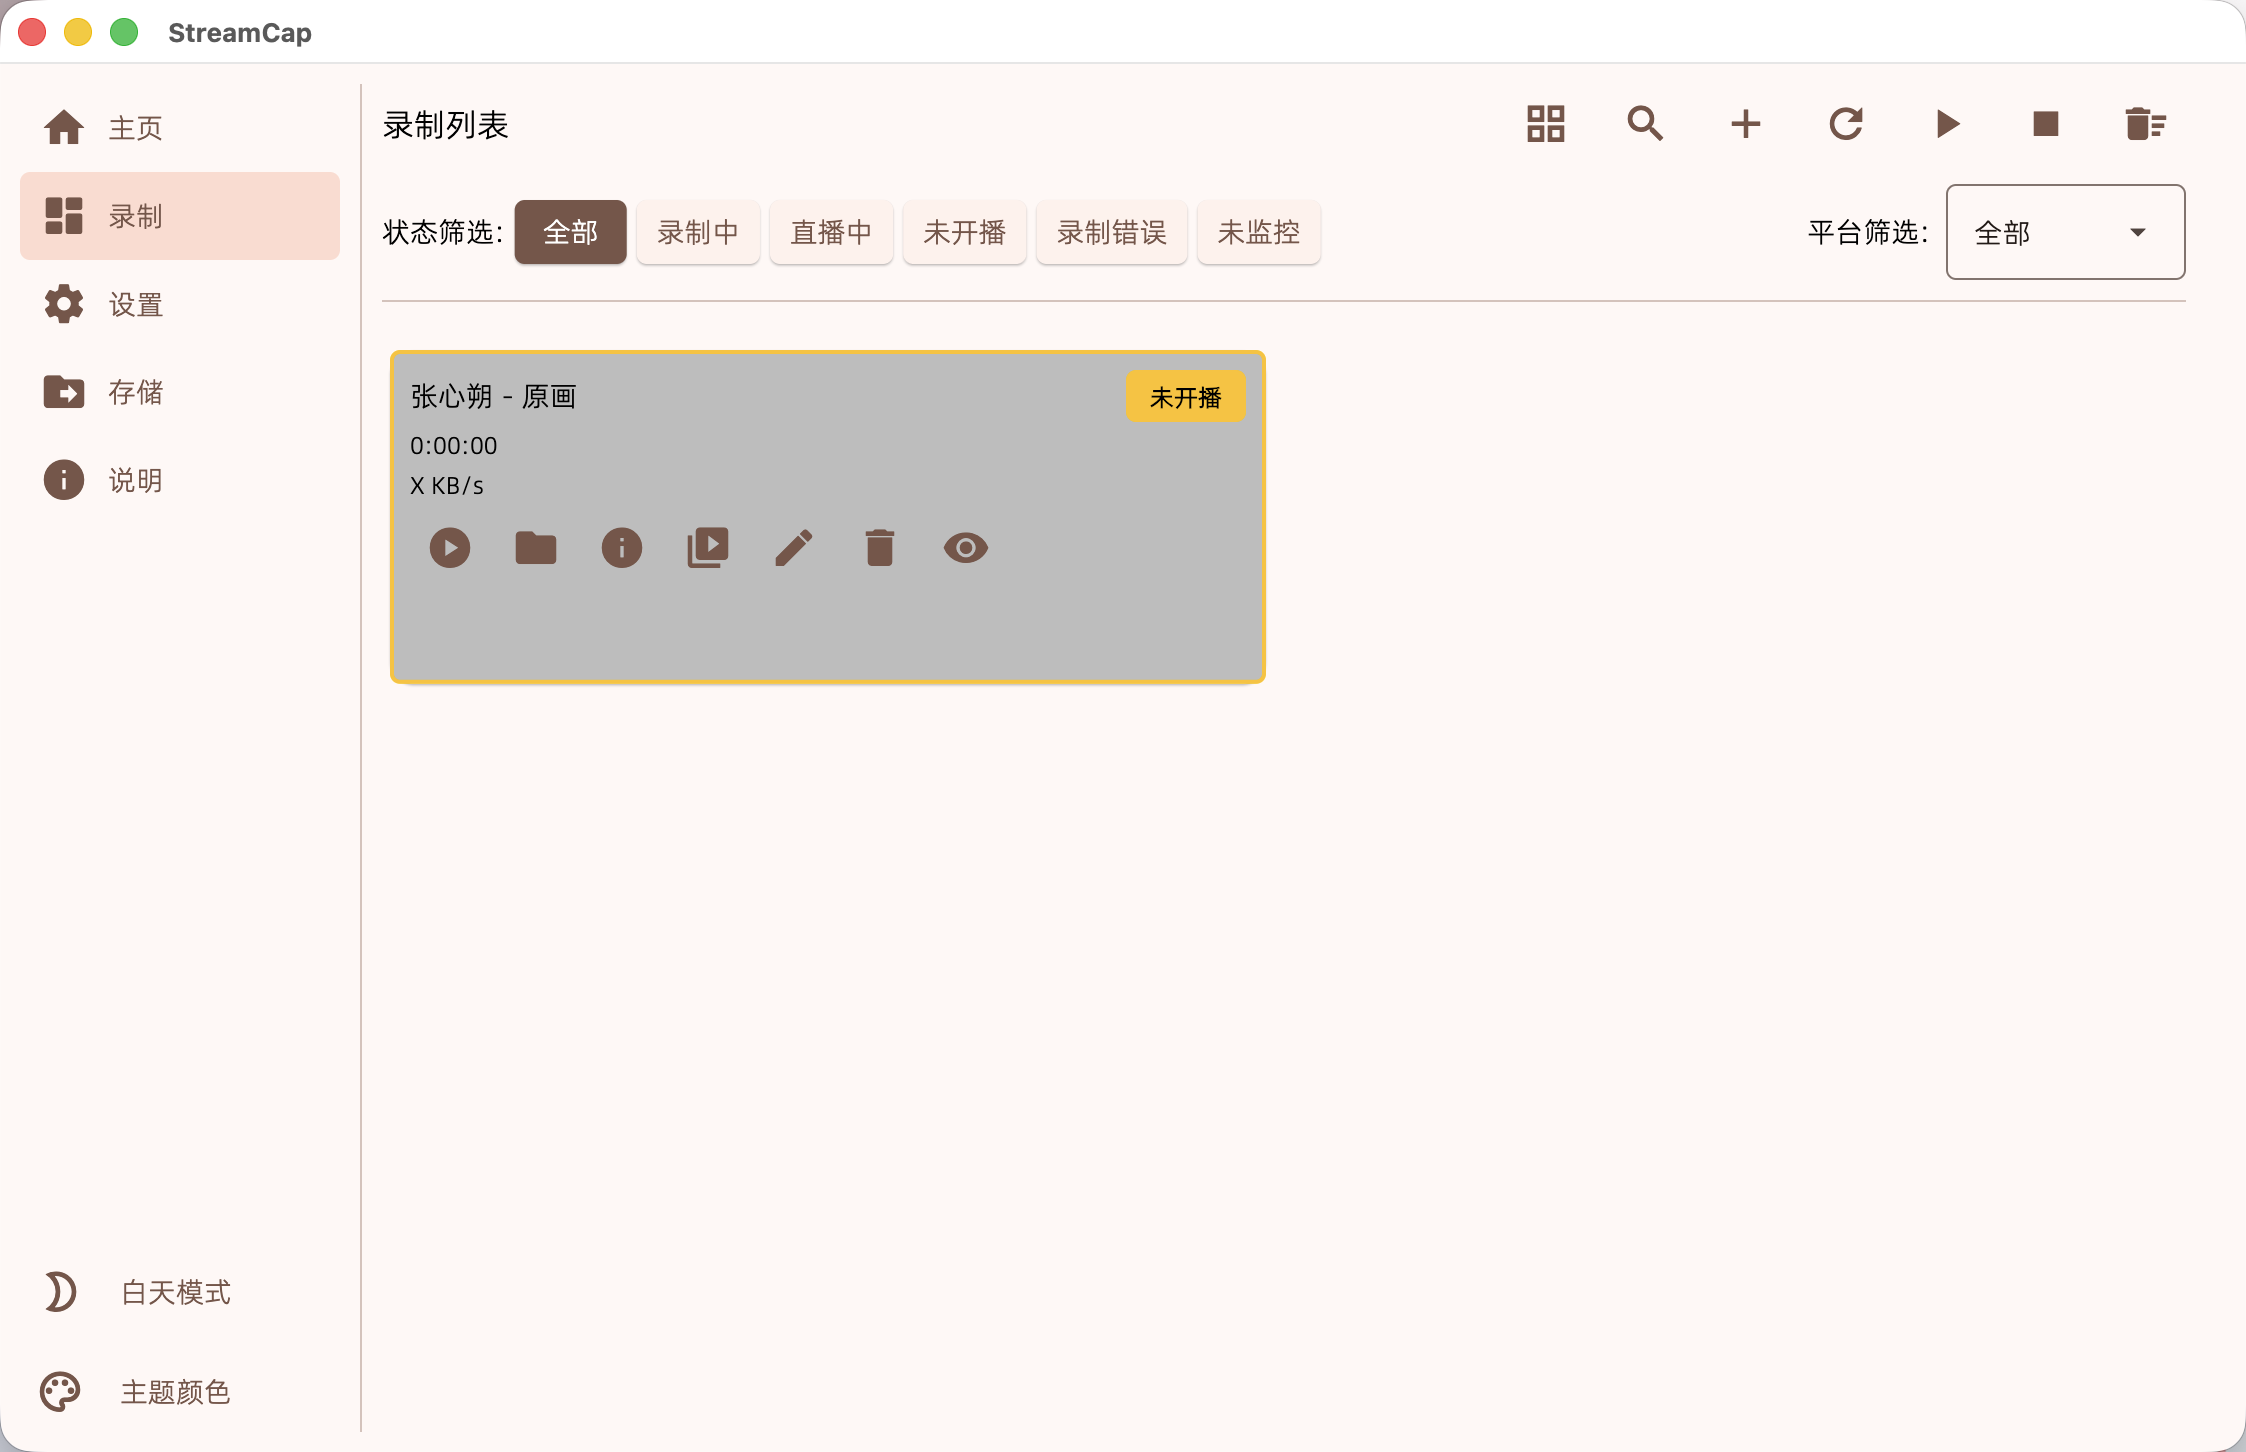
StreamCap 是一个基于 FFmpeg 的开源直播录制工具,支持 Windows、macOS 和 Web 方式运行,也支持抖音等多个直播平台。
从 Release 页面下载与系统对应的版本。Windows 解压后运行,macOS 下载 DMG 后安装即可。只从项目官方页面下载,不使用来历不明的打包版本。
打开 StreamCap 后,添加主播的公开主页地址或直播间地址,然后设置:
| 设置 | 建议值 | 说明 |
|---|---|---|
| 监控状态 | 开启 | 定时检查主播是否开播,开播后自动录制 |
| 录制格式 | M4A 或 WAV |
M4A 更省空间;WAV 更通用,但文件很大 |
| 分段录制 | 开启 | 长直播损坏时不会丢失整场内容 |
| 分段时长 | 600 秒 | 每 10 分钟一个文件,便于转写和重试 |
| 画质 | 任意 | 只录音时,最终文件不保存画面 |
| 自动转 MP4 | 关闭 | 音频总结不需要视频转码 |
| 录制目录 | 自定义目录 | 建议按平台和主播分别保存 |
这次实测使用的是 WAV:40 分钟约占 404 MB。它没有经过有损压缩,适合排查识别问题,但长期使用没有必要。日常监听更适合 M4A;如果已经录成 WAV,也不需要重新录制,Whisper 可以直接读取。
建议把轮询间隔设得保守一些。频繁请求直播状态可能触发平台风控,项目本身也可能因为抖音接口调整而需要升级。
第二步:安装本地 Whisper
下面使用开源的 OpenAI Whisper。它支持中文,并能在 Apple Silicon、NVIDIA GPU 或 CPU 上运行。
先安装 FFmpeg。macOS 可以使用 Homebrew:
brew install ffmpeg
然后使用 uv 创建独立环境:
uv venv
source .venv/bin/activate
uv pip install openai-whisper
Windows 激活环境时使用:
.venv\Scripts\activate
首次运行会下载模型。中文财经直播建议从 small 开始:它比 base、tiny 更能识别板块名和财经术语,速度又明显快于 large。遇到大量公司名、方言或多人连麦时,再考虑更大的模型。
第三步:批量转写分段音频
把下面脚本保存为 transcribe_live.py。它会读取一个目录中的常见音频格式,按文件名排序,输出带全局时间戳的 Markdown 文字稿。
import argparse
import json
import subprocess
from pathlib import Path

import torch
import whisper


def media_duration(path: Path) -> float:
    result = subprocess.run(
        [
            "ffprobe",
            "-v",
            "error",
            "-show_entries",
            "format=duration",
            "-of",
            "json",
            str(path),
        ],
        check=True,
        capture_output=True,
        text=True,
    )
    return float(json.loads(result.stdout)["format"]["duration"])


def timestamp(seconds: float) -> str:
    total = round(seconds)
    hours, remainder = divmod(total, 3600)
    minutes, seconds = divmod(remainder, 60)
    return f"{hours:02d}:{minutes:02d}:{seconds:02d}"


parser = argparse.ArgumentParser()
parser.add_argument("audio_dir", type=Path)
parser.add_argument("--model", default="small")
parser.add_argument("--output", type=Path, default=Path("transcript.md"))
args = parser.parse_args()

if torch.cuda.is_available():
    device = "cuda"
elif torch.backends.mps.is_available():
    device = "mps"
else:
    device = "cpu"

model = whisper.load_model(args.model, device=device)
extensions = {".wav", ".mp3", ".m4a", ".aac", ".flac"}
audio_files = sorted(
    path for path in args.audio_dir.iterdir() if path.suffix.lower() in extensions
)
if not audio_files:
    parser.error("录音目录中没有找到支持的音频文件")

offset = 0.0
lines = ["# 直播文字稿", ""]

for audio_path in audio_files:
    result = model.transcribe(
        str(audio_path),
        language="zh",
        fp16=device != "cpu",
        condition_on_previous_text=True,
        initial_prompt=(
            "这是一场中文财经直播,请准确识别股票、指数、板块、基金、"
            "公司名称、价格、涨跌幅和投资术语。"
        ),
    )

    for segment in result["segments"]:
        text = segment["text"].strip()
        if text:
            lines.append(f"[{timestamp(offset + segment['start'])}] {text}")

    offset += media_duration(audio_path)

args.output.write_text("\n".join(lines) + "\n", encoding="utf-8")
print(f"已输出:{args.output}")
运行方式:
python transcribe_live.py "/你的/主播录音目录" \
  --model small \
  --output "2026-07-22-直播文字稿.md"
分段文件必须能按名称正确排序。StreamCap 默认文件名包含时间和分段序号,一般可以直接使用。如果文件名是手工修改过的,先确认排序结果与直播顺序一致。
第四步:让 GPT 提炼观点
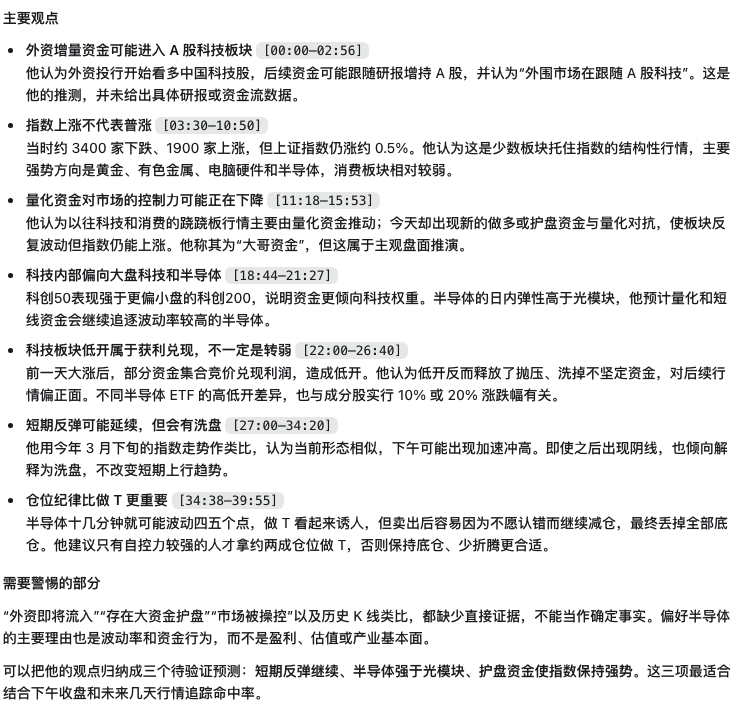
不要只让 GPT “总结一下”。财经内容需要明确区分主播的立场、观察到的数据和未经验证的推测。可以使用下面的提示词:
你是一名严谨的财经内容分析助手。请分析下面的直播文字稿。

要求:
1. 不要把主播观点写成客观事实。
2. 提取核心观点,并为每条观点保留对应时间戳。
3. 分别列出主播给出的论据、预测、操作倾向和风险提示。
4. 标出缺少证据的因果推断、市场传闻和可能的前后矛盾。
5. 股票、指数、公司名或数字如果疑似转写错误,请标记“待核对”,不要自行补造。
6. 最后整理出未来可以验证的三到五条预测。
7. 不提供个性化投资建议。

输出结构:
- 一句话结论
- 核心观点
- 操作与仓位倾向
- 缺少证据或需要核查的内容
- 后续验证清单

直播文字稿:
{在这里粘贴带时间戳的文字稿}
如果文字稿太长,可以每 10 至 20 分钟总结一次,最后再把各段摘要交给 GPT 做全场归并。第二轮提示中应要求模型合并重复观点、保留变化过程,并指出主播前后是否改变立场。
文章分享